今週のオープンソース・ローカルLLM界隈は、新しい巨大モデルの発表よりも「今あるモデルをどう速く・軽く・便利に動かすか」という推論基盤側の進化が目立った。Ollamaは量子化とエージェント向けキャッシュを強化し、LM StudioはスマホからPCのモデルを呼び出せるようにし、Liquid AIはRaspberry Piでも動く230MパラメータモデルでAI家電・ロボット向けの現実的な選択肢を示した。あわせて、ローカル推論の定番エンジンであるllama.cppとvLLMの使い分けも改めて整理する。
Ollama v0.30.8:MLXエンジンがNVFP4量子化とエージェント向けスナップショットに対応
Ollamaは2026年6月11日のブログで、Apple Silicon向けMLXエンジンの大幅強化を発表した。目玉はNVFP4という新しい4bit量子化フォーマットへの対応で、GoogleのGemma 4 12Bモデルで検証したところ、従来のq4_K_M形式に比べて量子化による品質劣化がおよそ半分に抑えられたという。データセンター向けに最適化されたNVFP4モデルをそのままデスクトップに持ち込めるため、クラウドとローカルの間でモデルを行き来させやすくなる。
加えて、Metalカーネルの融合やGPUサンプリングの見直しにより出力速度が最大20%向上。さらに注目すべきは「スナップショット」機能で、エージェントがサブエージェントに処理を委譲したり、複数セッションが同時に走ったりする場面で、共通するシステムプロンプトやツール定義、読み込んだファイルの再計算を省略できるようにした。長い会話の途中で分岐・再生成が起きても、分岐点から処理を再開できる点が特徴だ。
出典: Ollama Blog
LM Studio「LM Link」:自宅PCの大型ローカルモデルをiPhoneから使う
LM Studioは6月4日、モバイルアプリ「Locally」に新機能「LM Link」を搭載したと発表した。自宅やオフィスのPCで動かしている大きなローカルモデルに、外出先のiPhone・iPadから安全に接続して使える仕組みで、通信は端末間でエンドツーエンド暗号化され、チャット履歴も各端末にローカル保存される。
「フロンティア級の推論性能を自分のハードウェアで使う」こと自体は現実的になってきたが、常にその大型マシンのそばにいられるわけではない、という課題に対する回答だ。設定はLM Studio側でLM Linkを有効化し、Locallyアプリでペアリングするだけとシンプル。クラウドAPIを介さずに、自宅の高性能GPUをスマホから遠隔利用する発想は、プライバシー重視のローカルLLM運用における新しい形と言える。
出典: LM Studio Blog
Liquid AI、超小型オンデバイスモデル「LFM2.5-230M」を公開
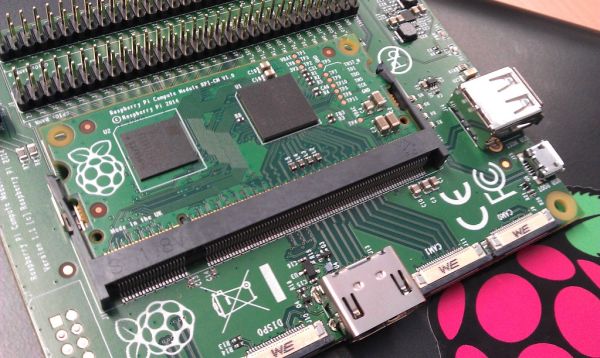
Liquid AIは自社最小となるLFM2.5-230Mを発表した。パラメータ数はわずか2.3億だが、19兆トークンで事前学習し、蒸留・DPO・多領域強化学習の3段階post-trainingを経ている。Raspberry Pi 5上で42 tok/s、Samsung Galaxy S25 Ultra(Snapdragon Gen4)上で213 tok/sのデコード速度を実現し、メモリ使用量も同クラス最小という。ベース版・post-trained版ともHugging Faceで公開済みだ。
ツール呼び出し(BFCL)やデータ抽出(CaseReportBench)のベンチマークでは、Gemma 3 1B ITやQwen3.5-0.8Bなど2倍以上のサイズのモデルを上回る場面もあった。Liquid AIはNVIDIA Jetson Orin搭載のUnitree G1ヒューマノイドロボットに本モデルを組み込み、自然言語の指示を歩行・片膝立ちなどのスキル呼び出しに変換するデモも公開している。数学やコード生成などの高度な推論には向かないとしつつ、エッジ機器やロボットの「言語理解インターフェース層」としての用途を明確に打ち出した格好だ。
出典: Liquid AI Blog
推論エンジンの選び方:llama.cpp と vLLM はどう違うのか
ローカルLLMの土台となる推論エンジンについて、Red Hat Developersの解説記事が改めて両者の違いをベンチマーク付きで整理している。llama.cppはCPUファーストの設計で、GGUF形式による4bit量子化を武器に、GPUなしの一般的なPCでもモデルを動かせるようにした立役者。OllamaやLM Studioも内部エンジンとしてllama.cppを使っている。一方vLLMは、PagedAttentionによるKVキャッシュ管理と連続バッチ処理で、データセンターGPU上での多数同時ユーザー対応に強みを持つ。
| 比較軸 | llama.cpp(Ollama/LM Studio等) | vLLM |
|---|---|---|
| 想定環境 | ノートPC・GPUなしでもOK | データセンターGPU(A100/H100等) |
| モデル形式 | GGUF(単一ファイル、量子化前提) | safetensors+FP8/INT8/INT4量子化 |
| 得意な用途 | 個人利用・プロトタイピング・オフライン | 多数同時ユーザーへの本番提供 |
| 同時64ユーザー時のスループット | 基準 | 約44倍(Red Hat計測) |
| API互換性 | OpenAI互換エンドポイント | OpenAI互換エンドポイント |
記事は「まずクラウドAPIで試作し、コストが気になったらllama.cppでローカル開発、本番展開でvLLMに移行する」という典型的な移行パスを紹介している。どちらもOpenAI互換APIを提供するため、エンドポイントのURLを差し替えるだけで移行できる点も実務上のポイントだ。
主な情報源
- Ollama Blog: Ollama’s highest performance on Apple Silicon yet with MLX
- LM Studio Blog: Run (your largest) local models from your iPhone
- Liquid AI Blog: LFM2.5-230M: Built to Run Anywhere
- Red Hat Developers: llama.cpp vs. vLLM
各サービスは提供元の規約に従ってご利用ください。情報は各情報源の公開時点のものです。収集・要約はAI、公開判断は人。