前回の投稿(【ワイン画像識別2026】ワイン照会システム試作)の最後に「エンベディングモデルの追加学習を次回のテーマとする」と言うようなことを書きましたが、いちおう画像識別に関しては及第点と思われる精度に到達していますし、そこを掘り下げるよりは別の重要なテーマに取り組んだ方がリターンが大きいのでは?と思えてきました。
と言うことで、突然ですが今回はワイン名での検索にチャレンジすることにします。
なお、今までは「ワイン画像識別」と銘打って投稿を続けてきましたが、今回から画像以外も対象となるため、今後は「ワイン識別」シリーズとして投稿していくことにします。
ワイン名の曖昧さ
そもそもラベル画像によるワイン識別に固執してきたのは、それがワインの検索方法として最適と判断したためです。
一般的に商品を検索したい場合、黙って商品名で検索するかと思いますが、ワインの名称って分かりにくい&覚えにくいものが多いんですよね。
例えば、以下のようなワインがあります。
このラベルから、ワイン名が分かりますかね?
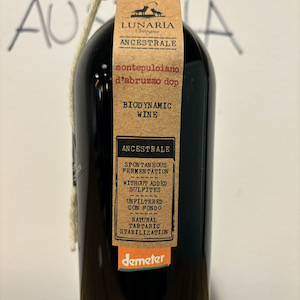
上記は、弊社ワイン販売サイト(SWAILIFE WINE SHOP)では「Lunaria Montepulciano Dabruzzo Ancestral Still Nature / ルナリア・モンテプルチアーノ・ダブルッツォ・アンセストラル・スティル・ナチュレ」と表記しています。
これは、「『ルナリア』ブランド(生産者はカンティーナ・オルソーニャ)として展開する、アブルッツォ州のモンテプルチアーノ種を使い、古来の自然な製法(アンセストラル・ナチュール)で造り上げた、泡のない(スティル)ワイン」と言う意味になるそうです。
しかし、長い…
上記で示したように、ワイン名は固有名詞と言うよりは、生産者(ワイナリー)やブランド、ブドウ品種、産地、醸造法、その他の特徴(非発泡性、ナチュラルワイン)等の組み合わせで表記されているケースが多く、それ故に同じワインでも表記のバリエーションが豊富です。
ネットで少し検索しただけでも以下のようなパターンが見受けられました。
まずは、原語表記から。
| Lunaria Montepulciano Dabruzzo Ancestral Still Nature (弊社) |
| Lunaria Montepulciano Dabruzzo Ancestral Biodynamic Still Nature |
| Montepulciano Dabruzzo Ancestral Biodynamic Still Nature |
| LUNARIA MONTEPULCIANO DABRUZZO |
| Lunaria Montepulciano d’Abruzzo |
日本語(カタカナ)表記でも同様です。
| ルナリア・モンテプルチアーノ・ダブルッツォ・アンセストラル・スティル・ナチュレ (弊社) |
| ルナリア モンテプルチアーノ・ダブルッツォ・アンセストラル・ビオディナミック スティル・ナチュレ |
| モンテプルチアーノ ダブルッツォ アンセストラル ビオディナミック ナチュレ |
| ルナリア モンテプルチアーノ・ダブルッツォ・アンセストラル・ナチュレ |
| ルナーリア・モンテプルチアーノ・ダブルッツォ |
原語表記の「Dabruzzo(アブルッツォ州の)」に関しては正確には「D’abruzzo」と表記されるものらしく、先に示したように、実際に後者の表記を採用しているサイトもあります。
また、「Biodynamic(ビオディナミック)」は農法・醸造法を示していて、弊社の名称には含まれていませんが、これを名称の一部に採用しているサイトもあります。
カナカナ表記では「Lunaria」を「ルナリア」ではなく「ルナーリア」と表記しているケースもありましたが、このような音訳の多様性(「カナ表記のゆれ」と言うようですが)に関しては枚挙にいとまがありません。
上記のように、そもそもワインには「これがこのワインの名前だ」という明確なものが存在せず、販売者側が属性を組み合わせて名前っぽく使っている場合も多いようです。
そのような状況なので、仮に目の前にワインがあったとして、そのワインがどのようなものか調べたくなった時に、名前で検索するという手段が取りづらい訳です。
先ほど提示した画像でも、ラベルの中のどの文字列を組み合わせるとワインの名称っぽくなるか、素人には分かりませんよね。
もっと言えば、文字が全く書かれていないようなラベルも存在しますし。
裏ラベルにはある程度文字情報が含まれますが、「商品名」を記載する法的な義務はない模様で、やはり確実にワイン名を確認する手段にはなり得ないようです。
よって、ラベル等からワイン名を読み取ることを期待せず、ラベル画像自体からワインを識別する方法を追求してきた訳です。
とは言うものの、ワイン名での検索が全く不要になったかと言うと、そうは思っていません。
やはり、名前での検索は基本ですし、曖昧ながらもワイン名がある程度分かっている場合もあると思います。
よって、改めてワイン名での検索方法を考えてみたいと思います。
ワイン名による検索の課題
前述のように、ワイン名に関しては構成する単語の選択や単語自体の表記のゆれによって、様々なパターンが発生します。
ワイン名での検索においては、上記点を考慮する必要が生じます。
例えば、検索文字列として「Lunaria Montepulciano d’Abruzzo」と指定された場合、単純には以下のようなSQLを考えたくなります。
SELECT * FROM wines
WHERE wine_name LIKE '%Lunaria%'
  AND wine_name LIKE '%Montepulciano%'
  AND wine_name LIKE '%d’Abruzzo%';
しかし、弊社表記では「d’Abruzzo」ではなく「Dabruzzo」となっているので、上記SQLではヒットしません。
「ルナーリア」と「ルナリア」でも同様でしょう。
ANDをORに変えればヒットするようになりますが、その場合は1つの単語でも一致すればヒット扱いとなるため、期待したものとは異なるワインが大量に出力されることになりかねません。
加えて、呪文のような聞きなれない単語の羅列であるため、タイポも発生しがちだと思います。
上記より、ワイン名による検索においては、指定された単語の全てが完全一致することを求めず、かと言ってごく一部のみの一致では良しとせず、検索文字列に対して納得感のある類似性を持った照合方法を検討する必要があります。
Trigram(pg_trgm)
前述したように、ワイン名による検索においては、表記ゆれやタイポを考慮した照合が必要であり、そのためには「一致・不一致」ではなく「類似度」による判定が必要になります。
それを実現する仕組みが「Trigram」です。
今回の実装では、PostgreSQLの拡張機能である「pg_trgm」を使用します。
例えば、”abcde”と”abxde”の類似度を考えてみます。
pg_trgmでは、比較対象の文字列に対して、先頭に2つ、末尾に1つのスペースを付加した上で、さらに連続する3文字の塊に分割します(Trigramとは厳密には前述した3文字の塊自体を指す言葉です)。
その結果は以下のようになります。
| abcde | ” a”, ” ab”, “abc“, “bcd”, “cde”, “de “ |
| abxde | ” a”, ” ab”, “abx“, “bxd”, “xde”, “de “ |
両者を比較すると、一致しているのは、” a”, ” ab”, “de ” の3件です。
一方で、2つの文字列のTrigramを重複なく抽出すると、全部で9件あります。
この結果から、2つの文字列の類似度は 3 / 9 ≒ 0.33 と判定されます。
類似度=0.33 という数値は低いように思われますが、pg_trgmの類似度閾値(似ていると判定する下限)のデフォルト値は 0.3 とのことなので、この判断基準からすると前述の2つの文字列は「似ている」と判定されることになります。
なお、Trigramを生成する段階で、先頭には2つのスペースを付加するのに対し、末尾には1つしかスペースを付加しない理由に関してAI先生に確認しましたが、今一つ釈然としませんでした(語尾に関しては記憶が曖昧になりがちで間違いやすいので、重要度を少し下げる意味で2文字の一致までしか判定していない、というような説明でしたが)。
また、先の計算過程から自明かと思いますが、文字数が多い単語の方がタイポには強いことになります。
この辺は、次に触れる問題とも関係します。
日本語→ローマ字変換
前述したTrigramによる判定はアルファベットを想定した比較になっています。
しかし、日本産のワインでは漢字やひらがな・カタカナが名称に使用されているケースは多いですし、前述したように原語表記とは別に日本語(カタカナ)表記情報を持ち、こちらで検索したいケースもあるでしょう。
pg_trgmではカタカナを直接扱うこともできるようですが、カタカナ表記は原語表記と比較して文字数が少なくなる傾向にあり、かつ表記ゆれも頻繁に発生します。
例えば「Lunaria」に関しては、原語表記(アルファベット)では7文字ですが、カタカナ表記では「ルナリア」(4文字)、「ルナーリア」(5文字)と文字数が減りますし、表記ゆれも考慮する必要が生じます。
よって、日本語に関してはローマ字変換した上でTrigramによる判定を行うようにします。
前述の「ルナリア」「ルナーリア」の比較を考えてみましょう。
まず、カタカナのまま比較した場合。
| ルナリア | ” ル”, ” ルナ”, “ルナリ”, “ナリア”, “リア “ |
| ルナーリア | ” ル”, ” ルナ”, “ルナー”, “ナーリ”, “ーリア”, “リア “ |
一致は、” ル”, ” ルナ”, “リア ” の3件。
2つの文字列のTrigramを重複なく抽出すると、全部で8件。
よって、類似度は 3 / 8 = 0.375 となります。
一方で、上記をローマ字化した後に比較してみます。
なお、長音(ー)は母音を繰り返す形で表現します。
| runaria | ” r”, ” ru”, “run”, “una”, “nar”, “ari”, “ria”, “ia “ |
| runaaria | ” r”, ” ru”, “run”, “una”, “naa”, “aar”, “ari”, “ria”, “ia “ |
一致は、” r”, ” ru”, “run”, “una”, “ari”, “ria”, “ia ” の7件。
2つの文字列のTrigramを重複なく抽出すると、全部で10件。
よって、類似度は 7 / 10 = 0.7 となります。
類似度の違いは一目瞭然です。
なお、ローマ字変換はPythonで一般的に利用されているライブラリで実現可能なのですが、同処理では漢字も含めてローマ字化できるようです。
ただし、辞書ベースで読みを決定しているため、例えば「橙露」(「トウロ」と読む)に関しては、橙が「だいだい」、露が「つゆ」と解釈され、「daidai tsuyu」と変換されます。
読みとしては間違っていますが、ワイン情報の登録時と検索時に同じ変換処理を使用することで等しく「daidai tsuyu」と変換されるため、類似度判定としては問題ありません。
テキストの正規化
上記のようにTrigramによる類似度判定を行うとして、先に例示した「d’Abruzzo」と「Dabruzzo」の比較はどうなるでしょう?
詳細は割愛しますが、類似度≒0.357程度になりそうです。
いちおう一致判定とはなりそうですが、大文字小文字の違いやアポストロフィ等の記号の有無など、予想可能な表記ゆれにより類似度が大きく下がってしまうのは嬉しくありません。
よって、名称に使用される文字列には以下の正規化を行なっています。
- 全角アルファベットは半角に変換
- アルファベットを全て小文字に変換
- 中黒(・)やハイフンは半角スペースに変換
- その他記号(アポストロフィ等)は全て除去
上記変換の結果、ワインの名称として入力された文字列とは異なる文字列が生成されるため、DB上には正式名称とは別に検索用別名として上記を登録しておきます。
検索時に入力された文字列は同様に正規化された上で、前述の検索用別名を対象としてpg_trgmによる類似度判定が行われます。
トークン単位マッチングと文字数加重スコアリング
最初に例示したワインの名称に関して、弊社の登録内容は「Lunaria Montepulciano Dabruzzo Ancestral Still Nature」でしたが、一方でWeb上での呼称には「Montepulciano Dabruzzo Ancestral Biodynamic Still Nature」というものもありました。
後者を検索文字列として指定した場合、弊社の名称には含まれない「Biodynamic」が問題となるのですが、その他の5つの単語が一致していることを考慮しないのも柔軟性に欠ける印象があります。
Trigramが単語に関して「類似度」を判定する手法だとすると、文字列全体の「類似度」を判定する手法があっても良いはずです。
そこで(AI先生が)考えたのが、トークン(単語)単位マッチングと文字数加重スコアリングです。
原理を理解しやすいように、検索文字列として以下を考えます。
“Lunaria Montepulcianno Dabruzzo Ansestral Sitll Nature”
上記は前述した「Lunaria Montepulciano Dabruzzo Ancestral Still Nature」を想定した検索文字列ですが、タイポが3箇所含まれています。
| トークン | タイポの内容 |
| Montepulcianno | n が重複 |
| Ansestral | c → s と誤入力 |
| Sitll | ti → it に入れ替わり |
上記検索文字列に対して、まずはトークンに分割し、それぞれのトークンに関する類似度を算出しますが、先に触れたようにTrigram(pg_trgm)では類似度が0.3未満のケースは不一致(似ていない)と判定すべきなので、一律に類似度=0としてしまいます。
その上で、トークンの文字数を重み(ウエイト)として、当該トークン単体のスコアを計算します。
| トークン | 文字数 | 類似度 | スコア |
| Lunaria | 7 | 1.00 | 7.00 |
| Montepulcianno | 14 | 0.81 | 11.34 |
| Dabruzzo | 8 | 1.00 | 8.00 |
| Ansestral | 9 | 0.54 | 4.86 |
| Sitll | 5 | 0.00 | 0.00 |
| Nature | 6 | 1.00 | 6.00 |
“Sitll” に関しては文字数の少なさが影響して、実際の類似度は0.2しかありません。
よって、トークン自体を不一致(類似度=0)とみなし、スコアは0となります。
トークン個別のスコアが算出できたら、全体を加算した上で、文字数で割ります。
(7.00 + 11.34 + 8.00 + 4.86 + 0.00 + 6.00) / (7 + 14 + 8 + 9 + 5 + 6)
= 37.2 / 49
≒ 0.759
上記をまとめると、検索文字列として指定された複数のトークンそれぞれの類似度に関して、トークンの文字数を重み(ウエイト)として加重平均を算出していることになります。
上記により算出されたスコアで一致・不一致を判断します。
なお、現在は最終的なスコアが 0.75 を超えた場合はヒット扱いとしていますので、先に示した複数のタイポを含む検索文字列でも「Lunaria Montepulciano Dabruzzo Ancestral Still Nature」がヒットすることになります。
ちなみに、上記閾値は現在までの試行結果から決定されたものであり、明確な根拠がある訳ではありません。
よって、今後の状況次第で調整していく必要があると思っています。
文字数を重みとしている点はタイポ対策としての意味を持ちます。
例えば「Cotes du Jura Chardonnay Chamois du Paradis」というワインがあります。
上記を想定した検索文字列として「Cotes du Jura」と入力するケースを考えます。
この時、「du」を「di」とタイポしてしまったらどうなるでしょう。
Trigramは短い単語のタイポには弱いので、当該トークンに関する類似度は 0.2 になります。
もし、文字数で加重平均せずにトークンごとの類似度を加算(0.3以下の類似度もそのまま採用)して平均を算出した場合、最終スコアは 2.2 / 3 ≒ 0.733 となり、ヒット扱いになりません。
一方で加重平均を採用することで、最終スコアは以下のように変わります。
(5 + 0 + 4) / (5 + 2 + 4)
= 9 / 11
≒ 0.818
無事、ヒット扱いとなります。
また、ワイン名において重要な品種名や生産者名などは往々にして文字数が多く、それらの一致をより重視するためという狙いもあります。
最後に、上記を踏まえて、最初に触れた検索文字列「Montepulciano Dabruzzo Ancestral Biodynamic Still Nature」で「Lunaria Montepulciano Dabruzzo Ancestral Still Nature」がヒットするか確認してみましょう。
| トークン | 文字数 | 類似度 | スコア |
| Montepulciano | 13 | 1.0 | 13 |
| Dabruzzo | 8 | 1.0 | 8 |
| Ancestral | 9 | 1.0 | 9 |
| Biodynamic | 10 | 0.0 | 0 |
| Still | 5 | 1.0 | 5 |
| Nature | 6 | 1.0 | 6 |
上記ケースでは類似度が0か1かなのでシンプルです。
(13 + 8 + 9 + 0 + 5 + 6) / (13 + 8 + 9 + 10 + 5 + 6)
= 41 / 51
≒ 0.804
無事ヒットとして認められました。
まとめ
Trigramにより単語レベルの類似度判定を行い、トークン単位マッチングと文字数加重スコアリングにより文字列全体の類似度判定を行うことで、ワイン名の曖昧検索が実現できました。
無論、現在の方式がベストという訳ではなく、余計な候補をリストアップしたり、逆に有効な候補を見落としたりということは十分にあり得ます。
それでも、検索文字列を構成する単語単位の部分一致AND検索よりは理想に近い検索が実現できたと思っています。
途中でも触れたように、最終スコアの判定閾値(0.75)に関しては今後も調整が必要かと思いますし、判定方法自体にも改善の余地はありますが、まずは現在の方式で様子を見ていきたいと思います。

